Try our cookiesAlza.cz a. s., Company identification number 27082440, use cookies and other data to ensure the proper functioning of the website and, with your consent, also, among other things, to personalize advertising and the content of our websites. By clicking on the “I understand“ button, you agree to the use of cookies and the transfer of data regarding the behavior on the website for displaying targeted advertising on social networks and advertising networks on other websites.
We use 8 categories of cookies on our website:
Technical cookies
These are strictly necessary for the functioning of the website and the features you choose to use. Without them, our website would not work; you wouldn't be able to log in to your user account, for example.
Functionality cookies
These cookies allow us to remember your basic choices and improve the user experience. These include remembering your preferred language or allowing you to stay logged in permanently.
Social media cookies
These cookies allow us to easily link you to your social media profile and, for example, allow you to share products and services with your friends and family.
Content personalisation
These cookies allow us to show you content and ads according to the information we have about you to best meet your needs. This includes what content you have viewed, or on what device you are accessing our website.
Non-personalised advertising
These cookies allow us to show you general ads for products and services.
Personalised advertising
Thanks to these cookies, we and our partners can offer you relevant products and services based on your purchases, your shopping behaviour and your preferences.
Audience metrics
These cookies allow us to optimise our site for your convenience based on how you use it. The aim is to remember or anticipate your choices. This includes, for example, the use of features, their location, or the behaviour on the page.
By giving your consent to the processing of cookies, functionality and analytical cookies will be installed on the device you use to browse the website (click on the "I understand" button for both categories, or you can select only one of the categories by clicking on the "Settings" button). We always install technical cookies on your device, even without your explicit consent, because without them our website would simply not work.
You can revoke your consent to the processing of cookies. In connection with our company's cookie processing, you also have the following rights: the right to access cookies, delete, modify, supplement and correct them, restrict processing and the right to lodge a complaint with the Office for Personal Data Protection. Read more about your rights.
A mesterséges intelligencia színre lép – először lassan, aztán hirtelen, mintha egy földönkívüli űrhajó repülne felénk, közel fénysebességgel. Az út nagy részében nem is látjuk, aztán feltűnik valami, de mire feldolgoznánk az információt, már itt is van. Az utóbbi időben több forradalmi mesterséges intelligencia modell is megjelent, amelyekre külön is kitérünk, de kezdjük először egy rövid történelmi áttekintéssel.
A cikk a szerző véleményét tükrözi, nem az Alza.hu álláspontját.
A mesterséges intelligencia kezdetei és a szimbolikus mesterséges intelligencia
A mesterséges intelligencia hullámokban érkezett hozzánk – az első hullám a 20. század 50-es éveiben kezdődött, amikor az olyan úttörők, mint Alan Turing és Marvin Minsky, elkezdték kidolgozni a mesterséges intelligencia kutatásának alapvető koncepcióit. Ebben az időszakban a szimbolikus, más néven szabályalapú megközelítés volt az uralkodó irányzat, amely szimbólumok és logikai szabályok használatára összpontosított a tudás reprezentálása és a következtetések levonása érdekében. Ennek a megközelítésnek tipikus példái voltak a tényekből és szabályokból következtető szakértői rendszerek. Például: „ha Alice és Bob nemzette a kis Charlie-t, Charlie fiú, Charlie élve született => Alice-nak van egy fia, Charlie, és Bobnak is van egy fia, Charlie”.
A szimbolikus mesterséges intelligencia tényekkel és szabályalapú következtetésekkel dolgozik (szakértői rendszerek, következtető rendszerek). A tényekből szabályok alapján új tényeket tudunk levezetni. A mesterséges intelligencia ilyen formája rendkívül munkaigényes – a struktúrát és a szabályokat fáradságos kézi munkával kell kitalálni és megadni.
A kapcsolatokat definiáló szabályokon alapuló reprezentáció beleütközik a kiszámíthatóság korlátaiba és a világ összes kapcsolatának leírhatóságának határaiba. A komplex világot még rengeteg szabállyal is nehéz leírni – sőt, olyannyira nehéz, hogy jelenleg úgy gondoljuk, lehetetlen. Ez egyébként az egyik oka annak is, hogy a központi tervezés miért nem működik.
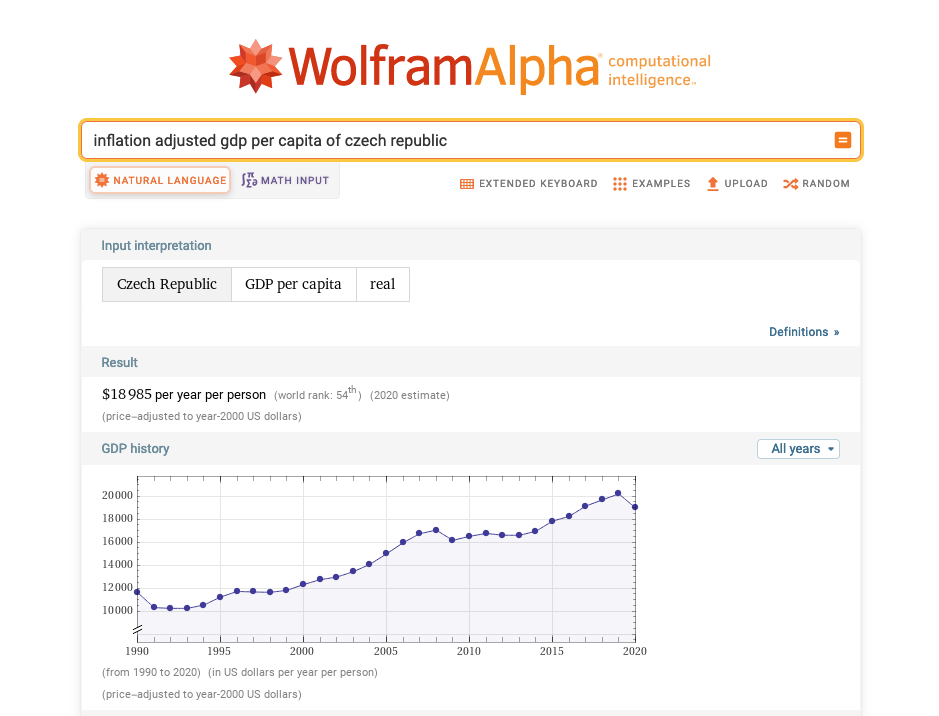
A „lehetetlenre” mégis több projekt is vállalkozott, például a Cyc projekt és annak nyílt forráskódú változata, az OpenCyc, amelyet azonban már nem fejlesztenek tovább. A jelenlegi, szimbolikus mesterséges intelligencia alapján működő projektek közül érdemes megemlíteni a WolframAlpha projektet, amely szimbolikus számítások segítségével meglehetősen kifinomult kérdésekre is képes válaszolni.
A szimbolikus mesterséges intelligencián alapuló Wolfram Alpha keresőmotor megértette a kérdést – az inflációval korrigált egy főre jutó GDP-re voltunk kíváncsiak. Az angol nyelvű mondatként megadott kérdést a „Czech Republic”, „GDP per capita”, „real” szimbólumokká alakította át.
A központi tervezés és a szimbolikus mesterséges intelligencia működésképtelenségének második oka a komplex világban az, hogy lehetetlen információt szerezni a világról – főként azért, mert az információk nagy része csak a döntés pillanatában, vagyis az inferencia idején keletkezik, amikor az idő előrehalad. Mondhatom, hogy kedvem van egy narancshoz, de ami igazán számít, az az, amikor megveszem (vagy megtermelem), meghámozom és megeszem – ez az információ tehát csak akkor jön létre, amikor már nem igazán hasznos az inferencia szempontjából, vagyis annak megállapításához, hogy valakinek érdemes-e narancsot termesztenie.
A szimbolikus mesterséges intelligenciának van azonban egy alapvető előnye a konnekcionista modellekkel szemben – mégpedig az, hogy képes megmagyarázni, miért jutott egy adott következtetésre. Egyszerűen felsorolja az alkalmazott szabályokat. Ez olyasmi, amire a jelenlegi mesterséges intelligencia modellek nem képesek.
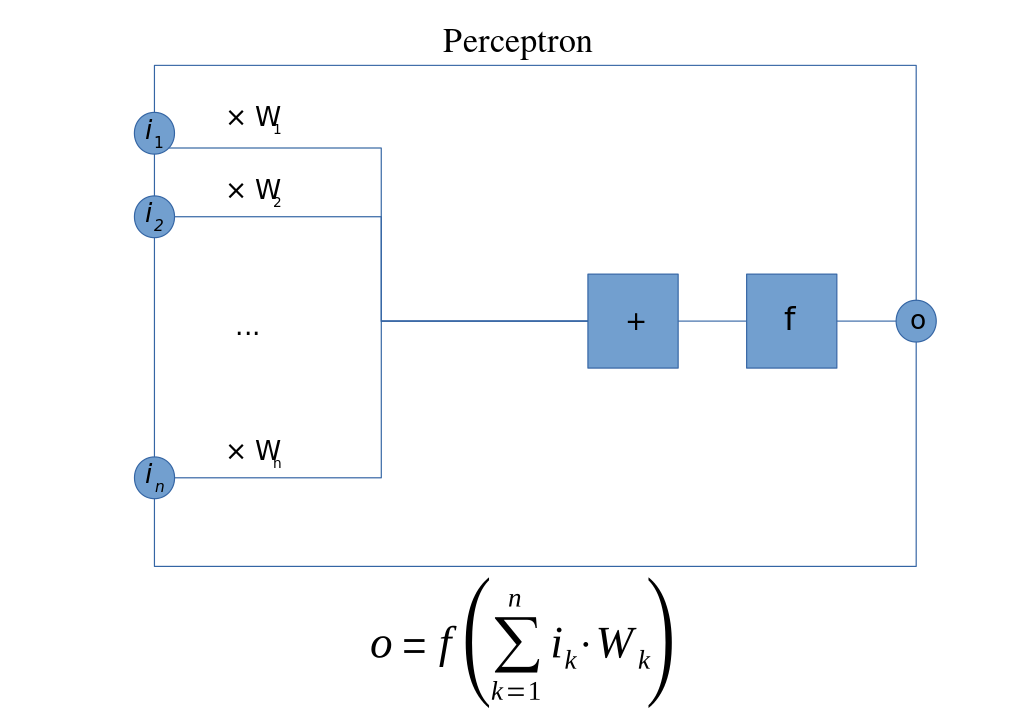
A perceptront úgy képzelheted el, mint egy egyszerű egységet, amely információkat dolgoz fel. Bemenetekből, súlyokból, a mért bemenetek összegzéséből és egy aktivációs függvényből áll. Mivel egy nagyon egyszerű modellről van szó, nézzük meg közelebbről:
Perceptron bemenetekkel (i1, I2, …, in), súlyokkal (W1, W2, …, WN) és f aktivációs függvénnyel. A perceptron alatt látható, hogyan számítja ki a kimenetet a bemenetekből. A kép forrása: Wikipédia, szerző: Mat the w.
Bemenetek: A perceptronnak több bemenete van, hasonlóan az agyunkban lévő neuronokhoz. Minden bemenethez egy adott érték és súly tartozik, amely meghatározza, mennyire fontos az adott bemenet. Úgy is felfoghatod, hogy bizonyos információk egy adott feladat szempontjából fontosabbak, mint mások. Például ha meg szeretnéd állapítani, hogy egy óra múlva szép nyári nap lesz-e, a hőmérséklet fontosabb információ, mint mondjuk az égbolt színe.
Súlyozott bemenetek összege: a súlyokat megszorozzuk a hozzájuk tartozó bemenetekkel, majd az eredményeket egyetlen számmá összegezzük. Ez olyan, mintha egy döntésnél felsorolnád az érveket és ellenérveket, ahol minden egyes pontnak meghatározott jelentősége vagy súlya van.
Aktivációs függvény: az eredményt ezután egy küszöbértékkel (threshold) hasonlítjuk össze az aktivációs függvény segítségével. Ha az eredmény meghaladja ezt a küszöböt, a perceptron az egyik értéket adja ki (például 1-et), ellenkező esetben a másikat (például 0-t). Ez olyan, mint egy döntés, amelyet a súlyozott érvek és ellenérvek listája alapján hozol meg.
A mesterséges intelligencia egyik kulcsfogalma a „tanulás” – a perceptron úgy tanul, hogy megkeresi azokat a súlyokat, amelyek a legjobban megoldják a problémát. Ha például bizonyos bemenetekhez ismerjük a helyes kimeneteket (vannak példáink), elvégezhetjük a számítást, és megnézhetjük, hogy a perceptron helyes eredményt adott-e. Ha tévedett, akkor az ún. hibavisszaterjesztéssel (backpropagation) történik a tanulás. Megvizsgáljuk, mennyit tévedett, és melyik súlynak mekkora szerepe volt ebben. A hibavisszaterjesztés algoritmusa, más néven backpropagation, az egyik leggyakrabban használt tanulási algoritmus.
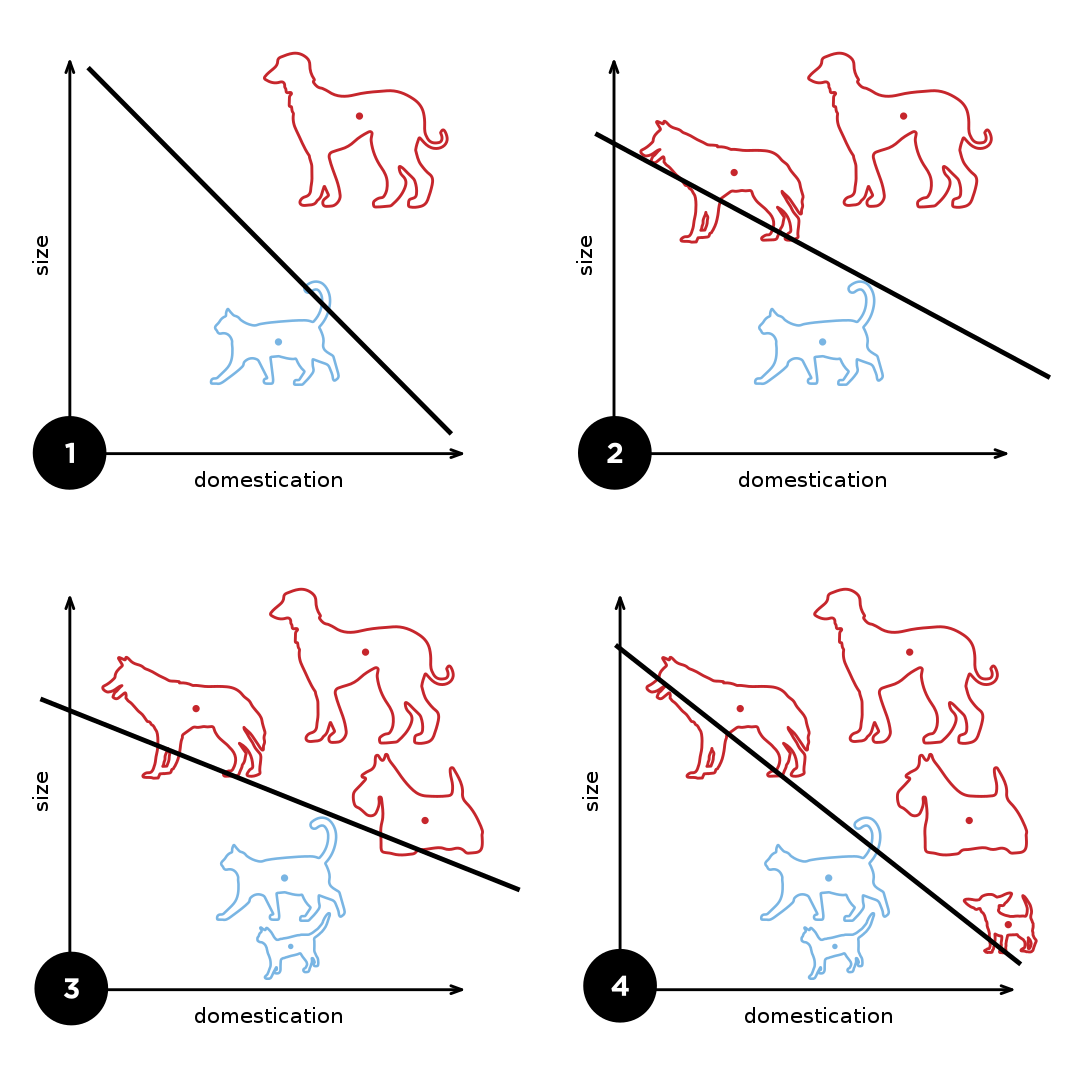
A perceptron tanulásának elve. A kép a Wikipédiáról származik, Elizabeth Goodspeed munkája, CC BY-SA 4.0.
A képen kezdetben egy kutya és egy macska látható. Mivel lineáris függvényt ír le, valójában egy olyan vonalat keres, amely elválasztja a kétféle példát egymástól. Ha csak két példa áll rendelkezésre, találhat például egy olyan vonalat, mint a kép első részén, ami működik. Egy újabb kutya hozzáadásával a tanítóhalmazhoz módosítani kell a vonalat, mert az eredeti vonal a kutyát macskának sorolná be. Ahogy egyre több példát adunk a tanítóhalmazhoz, a vonal folyamatosan módosul. Előfordulhat azonban, hogy egyetlen vonal nem elegendő a példák szétválasztásához, és egy összetettebb függvényre van szükség, amely nemlineáris határvonalat tud húzni a példák közé.
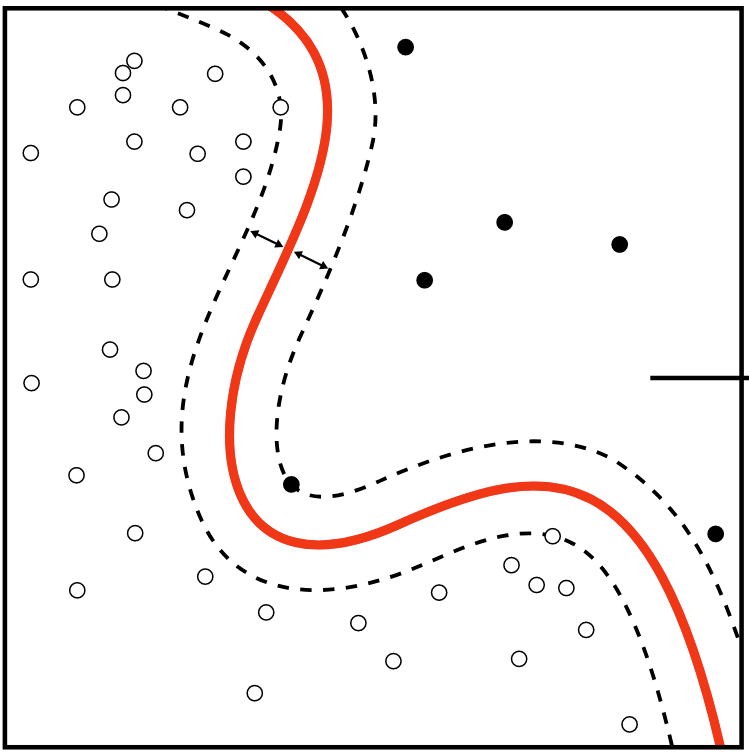
Ezt a korlátot Marvin Minsky és Seymour Papert írta le „Perceptrons: an introduction to computational geometry” című könyvében. A perceptron csak olyan feladatokat képes megoldani, amelyek lineárisan szeparálhatók, vagyis létezik egy sík (vagy egyenesen egy vonal), amely képes az adatokat különböző kategóriákba elkülöníteni. Talán a legegyszerűbb példa, amely nem szeparálható lineárisan, a logikai XOR függvény.
A képen látható teli és üres köröket nem lehet egyetlen vonallal elválasztani – nemlineárisan szeparálhatók. Ezt a feladatot a perceptron nem tudja megoldani, és nemlinearitást kell bevezetnünk – vagyis „meg kell görbítenünk az elválasztó vonalat”. Forrás: Wikipédia, Alisneaky Vector: Zirguezi, CC BY-SA 4.0
Ez az egyik oka annak, hogy manapság kifinomultabb neurális hálózatokat használnak, amelyek bonyolultabb, nemlineáris feladatok megoldására is képesek.
A Turing-teszt
Alan Turing az intelligencia tesztjét egy „utánzási játék” segítségével határozta meg egy csevegőfelületen (ma Turing-tesztként ismerjük). A tesztet az 1950-ben megjelent „Computing Machinery and Intelligence” című cikkében mutatta be. Ha egy csevegőfelületen nem tudjuk megbízhatóan megkülönböztetni az embert a géptől, akkor a gép átment az intelligenciateszten, és azt mondjuk, hogy a gép a mesterséges intelligencia egy bizonyos, „emberi szintű” formájával rendelkezik. A kritikusok szerint a csevegőablakban megnyilvánuló intelligencia nem tükrözi az emberi intelligencia teljességét – szerintük az emberi viselkedés sikeres utánzása nem egyenlő a valódi megértéssel vagy tudatossággal.
Turing-teszt. A bíró megpróbálja kideríteni, hogy az illető egy másik emberrel vagy egy old-school UNIX-terminál mögött ülő számítógéppel levelezik-e.
Minsky és Papert perceptronokkal – egyszerű neurális hálózatokkal – végzett munkája, valamint az általuk feltárt korlátok szkepticizmust váltottak ki a neurális hálózatok potenciáljával szemben, egészen a mesterséges intelligencia második hullámának kezdetéig a 80-as és 90-es években.
A mesterséges intelligencia második és harmadik hulláma
A második hullámot a konnekcionista modellek és a biológiai neurális hálózatok által inspirált neurális hálózatok felé fordított figyelem jellemezte. A kutatás jobb tanulási algoritmusok felé irányult, újra felfedezték a hibavisszaterjesztés (backpropagation) algoritmusát, amely lehetővé tette a neurális hálózatok számára, hogy adatokból tanuljanak. A kutatást azonban korlátozta a rendelkezésre álló számítási kapacitás és a betanítási adatok elérhetősége.
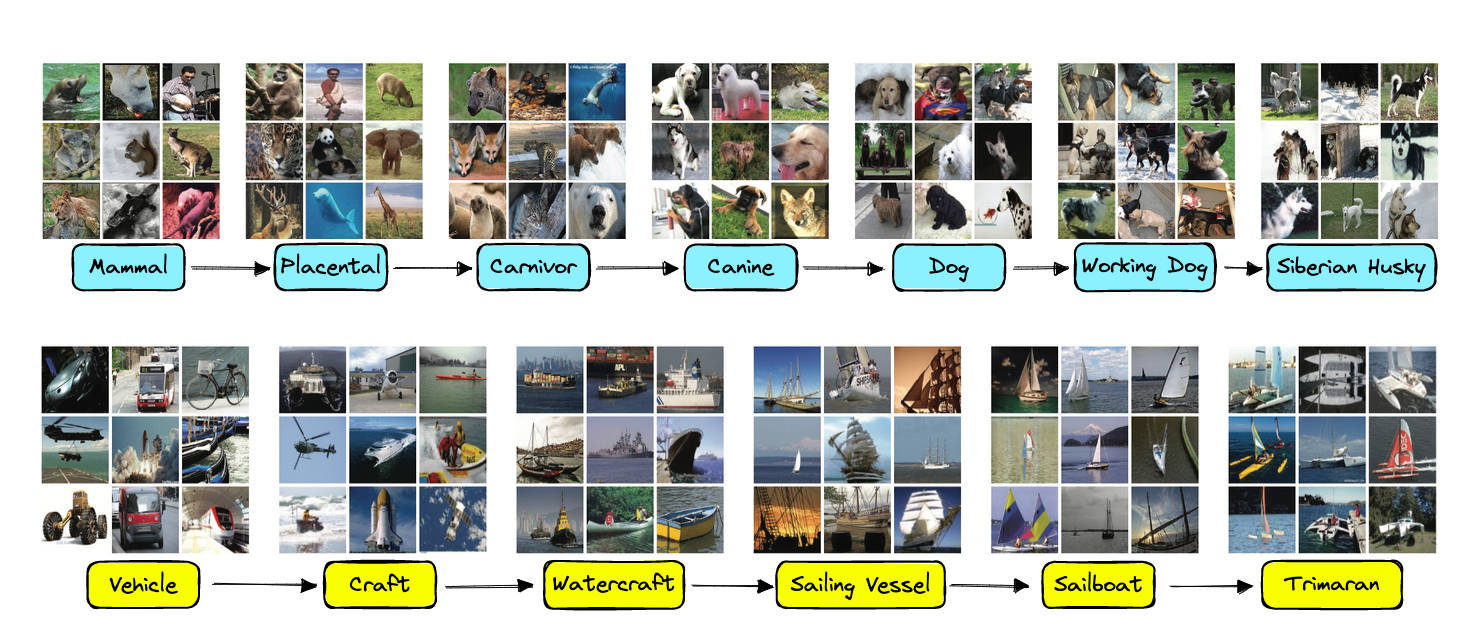
A harmadik hullám 2010-ben kezdődött, és a mai napig tart. A megnövekedett adatmennyiség (gyakran címkézett adatok), a számítási kapacitás és az új neurális hálózati architektúrák (konvolúciós neurális hálózatok, rekurrens neurális hálózatok és transformerek) konvergenciájának köszönhetően jött létre. A megnövekedett számítási és memóriakapacitásnak hála sok réteggel és neuronnal rendelkező neurális hálózatokat lehetett betanítani (az ilyen hálózatokat „deep”, azaz mélynek nevezzük, ami a rétegek számára utal). Az adatokat az internet szolgáltatta – robotok által bejárt és indexelt weboldalak, valamint címkézett adatkészletek, mint például az ImageNet, ahol emberek írták le a képeket (cica az asztalon, táncoló hód stb.). Ezeknek az eseményeknek és a rengeteg emberi munkaidőnek a konvergenciája indította el a forradalmat. Az ImageNet 12 millió képet tartalmazott, amelyeket a WordNet ontológia alapján írtak le. Ha egyetlen ember annotálta volna az adatokat percenként egy kép sebességgel, és semmi mást nem csinált volna (beleértve az alvást és az evést sem), 22 évbe és 10 hónapba telt volna.
Képek besorolása az ImageNet projekt taxonómiájába.
Ezeknek az innovációknak és a technológiai fejlődésnek az eredményeként születtek meg az olyan képgeneráló modellek, mint a Stable Diffusion (valamint a DALL-E és a MidJourney), amelyek szöveges leírásból képesek képeket létrehozni, továbbá a nagy nyelvi modellek csevegőfelületei, mint például a ChatGPT, a Bing vagy a Bard.
A nyílt forráskódú innovációk színre lépnek
A történet talán legizgalmasabb fejezete azonban a nyílt forráskódú innováció. Ezt a Google-nél is felismerték – legalábbis ha hiteles ez a kiszivárgott dokumentum. A Stable Diffusion egy nyílt forráskódú képgeneráló modell, amely az innovációk egész lavináját indította el. Az emberek elkezdtek úgynevezett „fine-tuned” modelleket tanítani és közzétenni – az alapmodell felhasználásával egyetlen délután alatt úgy finomhangolták a neurális hálózatot, hogy az például jobb portrékat, manga figurákat vagy az én kedvenc synthwave képeimet generálja. Ezeket a programokat a saját gépeden is futtathatod – akár egy elég erős videokártyával, akár modern, neurális hálózatok gyorsítására képes hardveren, például az új Apple Silicon processzoros Apple eszközökön (mindegy, hogy iPhone-ról vagy MacBook Pro-ról van szó).
Hasonló innovációs hullám söpört végig a nyelvi modellek területén is. Bár korábban is létezett jó néhány nyílt nyelvi modell, az igazi áttörést a Meta Llama modellcsaládja hozta el. A Llama azóta a 3-as generációig fejlődött, és a kompakt, mobilra szánt 1–3 milliárdos verzióktól a 8 és 70 milliárdos kategórián át egészen a csúcskategóriás, 405 milliárd paraméteres óriásmodellig terjed. A paraméterszám közvetlenül meghatározza a szükséges hardverigényt, azonban a mai fejlett eljárásokkal – mint a 4 bites kvantálás – egy 8 milliárd paraméteres modell mindössze 5-6 GB VRAM-mal is kiválóan futtatható akár egy átlagos videokártyán vagy laptopon. A hatékonyabb tanítási módszereknek köszönhetően a mai kisebb modellek teljesítménye már a korábbi generációk nagyságrendekkel nagyobb változatait is messze felülmúlja.
Az igazán érdekes azonban az volt, hogy sok más modellel ellentétben ezt nem nyílt forráskódú licenc alatt adták ki. A tanulmányt és a tanítási kódot ugyan nyilvánosságra hozták, de a betanított súlyokat (vagyis a költséges tanítási folyamat végeredményét) csak kiválasztott kutatók kapták meg, kizárólag nem kereskedelmi célokra. Hamarosan azonban a projekt GitHub oldalán az „issues” között felbukkant egy magnet link egy torrenthez, amely az összes súlyt tartalmazta, azzal a megjegyzéssel, hogy ugye nem lenne illő ekkora adatforgalommal terhelni a Facebook szervereit. Később a modell megjelent a Hugging Face portálon is, ami egyfajta „GitHub az AI modelleknek és adathalmazoknak”. A Meta nem lépett fel a közzététel ellen, de továbbra is azt az álláspontot képviseli, hogy a modell kizárólag nem kereskedelmi felhasználásra készült.
Ami ezután történt, az viszont lenyűgöző, és jól mutatja a nyílt forráskódú közösség erejét. Erről szól a Google-ből kiszivárgott dokumentum is. Ez a modell az innovációk őrült hullámát indította el.
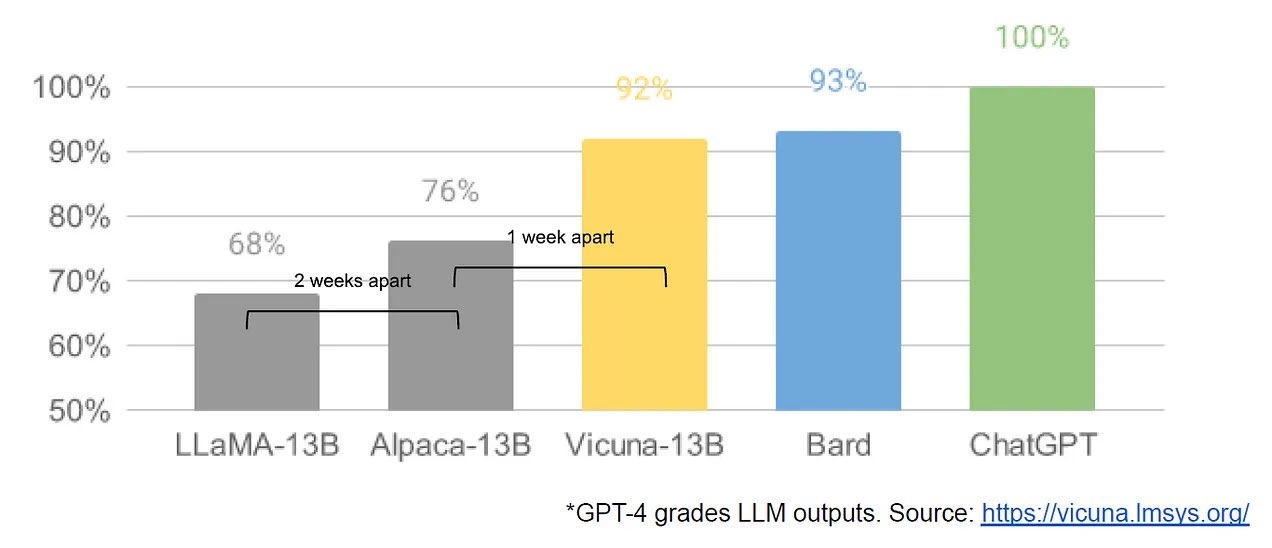
A nyílt vagy részben nyílt modellek fejlődési sebessége elképesztő. A LLaMA-13B és az Alpaca-13B között mindössze két hét telt el, egy héttel az Alpaca után pedig megszületett a Vicuna-13B adathalmaz és modell. A GPT-4 által végzett minőségértékelés a LLaMA 68%-áról az Alpaca 76%-án át a Vicuna 92%-ára ugrott. Három hét alatt!
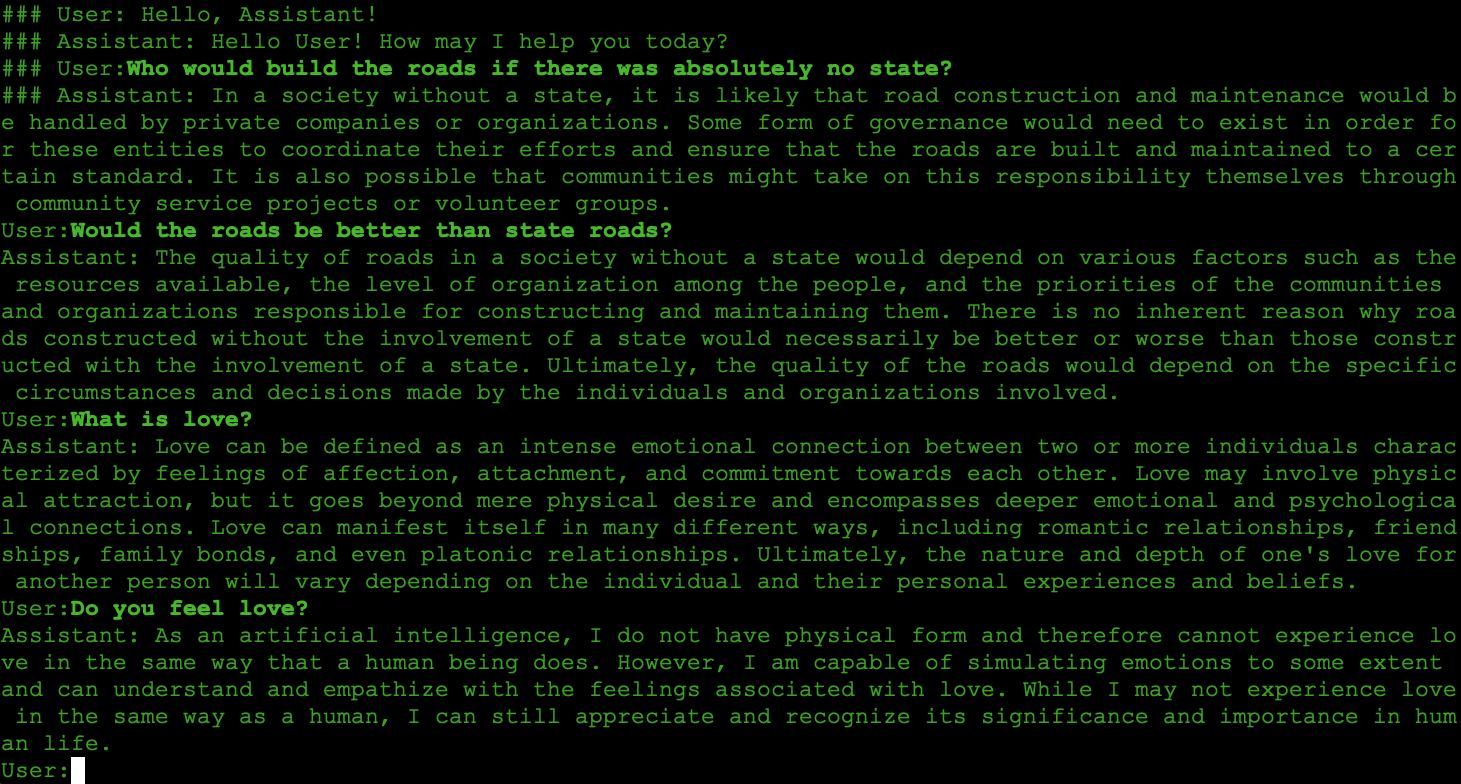
Az eredeti LLaMA verzió kizárólag szöveges adathalmazon lett betanítva. Képes volt „folytatni a szöveget”, vagyis nem tudott utasításokat követni, és nem volt alkalmas közvetlen párbeszédre sem. Nagyjából az OpenAI GPT-3 modelljének szintjén állt (165 milliárd paraméterrel). Mindössze két héttel később a LLaMA-13B-ből megszületett az Alpaca-13B, amely már képes volt utasításokat követni. A LoRA (Low Rank Adaptation) technológiával végzett finomhangolás a Stanford Egyetem kutatóinak 600 USD-be került számítási kapacitásban. A közzétett tanító adathalmazt, amelyet a ChatGPT-vel való API-s interakciók révén hoztak létre, mások is felhasználták további finomhangolásra és a súlyok közzétételére. Egy héttel később megszületett a Vicuna-13B adathalmaz, amelyet már érdemes a ChatGPT-vel összehasonlítani. Klasszikus társalgási felülettel rendelkezik, amilyet a ChatGPT-ből ismersz. A fő különbség azonban az, hogy a hatalmas vállalati struktúrákon kívül, finomhangolással jött létre (bár természetesen a költségek nagy részét a Meta fizette a fő modell betanításával). És képes vagy a saját eszközödön futtatni anélkül, hogy bárkinek bármit küldenél.
Beszélgetés a Vicuna-13B modellel. A LLaMA-val ellentétben klasszikus társalgási felülettel rendelkezik, amilyet a ChatGPT-ből ismerünk.
Azóta a nyílt forráskódú ökoszisztéma gyökeresen átalakult: a korai kísérleti projektek helyét olyan érett modellcsaládok vették át, mint a Mistral, a Gemma vagy a Qwen. Ma már nem feltétlenül a modellek drága finomhangolása a fő irány, ha speciális szakterületekről van szó. Egy ügyvédi iroda vagy egy orvosi praxis esetében a legmodernebb megközelítés a RAG (kereséssel kibővített generálás) és az AI ágensek használata, amelyek közvetlenül a saját, zárt dokumentumtárból dolgozva nyújtanak pontos válaszokat. A multimodalitás – a képek, dokumentumok, hang és kód egyidejű értelmezése – mára alapkövetelménnyé vált. Mivel a Meta a Llama legújabb generációit már kereskedelmi használatra is szabaddá tette, a vállalatok biztonságosan építhetnek a nyílt alapmodellekre, miközben az alapmodellek hatékonysága és képességei továbbra is rohamléptekkel fejlődnek.
A nyílt modellek egyik legnagyobb előnye, hogy akár közvetlenül a végfelhasználói eszközökön is futtathatók. Ez kulcsfontosságú azokban a környezetekben, ahol a szigorú adatvédelmi előírások miatt nem tölthetők fel érzékeny adatok a felhőbe, vagy ahol nem áll rendelkezésre folyamatos internetkapcsolat.
A helyi futtatás lehetőségével egy teljesen új korszakba léptünk. A fejlődés ráadásul olyan gyors, hogy amíg ezeket a sorokat olvasod, valószínűleg már újabb mérföldköveket értek el a fejlesztők – és ez így van rendjén.
Amit a korai generációknál láttunk, az még csak az alapok megvetése volt. Mára a technológia beérett: a lokálisan futtatható, biztonságos és célorientált AI-megoldások a mindennapi munkafolyamatok szerves részévé váltak. Ez azonban még nem a végállomás, hanem a mesterséges intelligencia leghatékonyabb és legizgalmasabb korszakának kezdete – a sorozat következő részeiben ezt a gyakorlati dimenziót vizsgáljuk meg közelebbről.
Juraj Bednár
Cypherpunker vagyok, szeretem a szabadságot, a magánéletet, a peer-to-peer technológiát és a terminálablakokat. Felfedezem a kaotikus világot, az illékonyságot és a bizonytalanságot, küzdök az entrópia ellen - cégeket és nonprofit szervezeteket alapítok, tanfolyamokat tartok és könyveket írok. Társalapítója vagyok a Parallel Polisnak, a Progressbar hackerspace-nek és a Hacktrophy nevű bug bounty platformnak. Mesterséges intelligencia szakon végeztem és rajongok mindenért, ami ezzel kapcsolatos. A tapasztalataim által ihletett blogomat itt olvashatod.
Voice Assistant - OS supported: Android and iOS controls your smart home and plays music, 1 ambient sound microphones, Microphone mute button, language used: English.
PC Power Supply - 600 W, ATX form factor, 80 PLUS White certification, 80 % efficiency, power switch, 1× EPS/CPU 4+4pin, 2× PCI Express 8-pin / 6+2-pin, 5× Serial ATA 15-pin, 3× Molex HDD 4-pin connectors, dimensions 150 × 86 × 140 mm (W×H×D)
Uninterruptible Power Supply - tower UPS, backup time at 100% load 2 min, backup time at 50% load 9.8 min, actual and apparent performance 810 W / 1350 VA, max. output voltage 230 V, line interactive, 6×Schuko, protection data network RJ-45, USB and RS-232 , USB for charging, LCD display and AVR, dimensions 280 × 100 × 355 mm (H×W×D), weight 10 kg
Voice Assistant - Google Home, OS supported: Android and iOS controls your smart home and plays music, 1 ambient sound microphones, Microphone mute button, US distribution, language used: English.
Voice Assistant - Manufacturer app, OS supported: Android and iOS controls your smart home and plays music, 2 ambient sound microphones, Headphone output and Microphone mute button, language used: English, Czech and Slovak.
Work Station , NVIDIA GB10, NVIDIA GB10 128GB, RAM 128GB LPDDR5x, SSD 1000GB, Without Optical Drive, Wi-Fi, USB-C and HDMI 2,1, Case Type: SFF, NVIDIA DGX OS 7
Work Station , NVIDIA GB10, NVIDIA GB10 128GB, RAM 128GB LPDDR5x, SSD 4000GB, Without Optical Drive, Wi-Fi, HDMI and USB-C, Case Type: SFF, NVIDIA DGX OS 7
Reader - USB biometric security key and fingerprint reader for Windows, FIDO2, WebAuthn, support for Windows Hello™ and Windows Hello™ for Business, for web browsers: Edge, Firefox, password manager: LastPass, Dashlane, Keeper, Roboform, compact design, USB-A.
Hardware Wallet - enables the purchase, sale, and exchange of cryptocurrencies, Samsung S3D232A chip, EAL6+ certification, passphrase for easy access, resistant to water, dust, X-ray, electromagnetic pulse, and electrostatic discharge resistant, connected to the Tango app, dimensions 85.6×54×1mm, weight 6g
Central Unit - used as security and home control, connect using WiFi 2,4 GHz, WiFi 5 GHz, Ethernet and Radio frequency, communication via Apple Home and Manufacturer app, compatible with Android and iOS, power plug power supply
Hardware Wallet - Encryption, Windows compatible, Linux, Android, USB-C, CC EAL6+ certification, ST33K1M5 chip, support for a large number of currencies, including the recovery key, easy to use
Hardware Wallet - Encryption, Windows compatible, Linux, Android, USB-C, CC EAL6+ certification, ST33K1M5 chip, support for a large number of currencies, easy to use
Uninterruptible Power Supply - rack UPS, actual and apparent performance 1800 W / 2000 VA, rack position height 2U, online with double conversion, 3×Schuko, USB and RS-232 , dimensions 88 × 438 × 410 mm (H×W×D), weight 19 kg
PC Power Supply - 650 W, ATX form factor, 80 PLUS Gold certification, detachable cables, thermal speed control and power switch, 120 mm fan size, 2× EPS/CPU 4+4pin, 1× PCI Express 16-pin, 2× PCI Express 8-pin / 6+2-pin, 6× Serial ATA 15-pin, 3× Molex HDD 4-pin connectors, dimensions 150 × 86 × 140 mm (W×H×D)
PC Power Supply - 850 W, ATX form factor, 80 PLUS Gold certification, detachable cables, thermal speed control, power switch and zero RPM mode, 135 mm fan size, 2× EPS/CPU 4+4pin, 1× PCI Express 16-pin, 3× PCI Express 8-pin / 6+2-pin, 8× Serial ATA 15-pin, 3× Molex HDD 4-pin connectors, dimensions 150 × 86 × 140 mm (W×H×D)